DaybyDay ISSN 1860-2967
Ja, in den vergangenen Jahren ist das Interesse an den Publikationen auf dieser Plattform immer weiter gewachsen, zuletzt im Bereich von täglich fünfstelligen Zugriffen - bis dass die Zugriffe der Maschinen die der Menschen bei weitem überholt haben.
Hier eine statistische Auswertung aus dem vorangegangenen Monat:
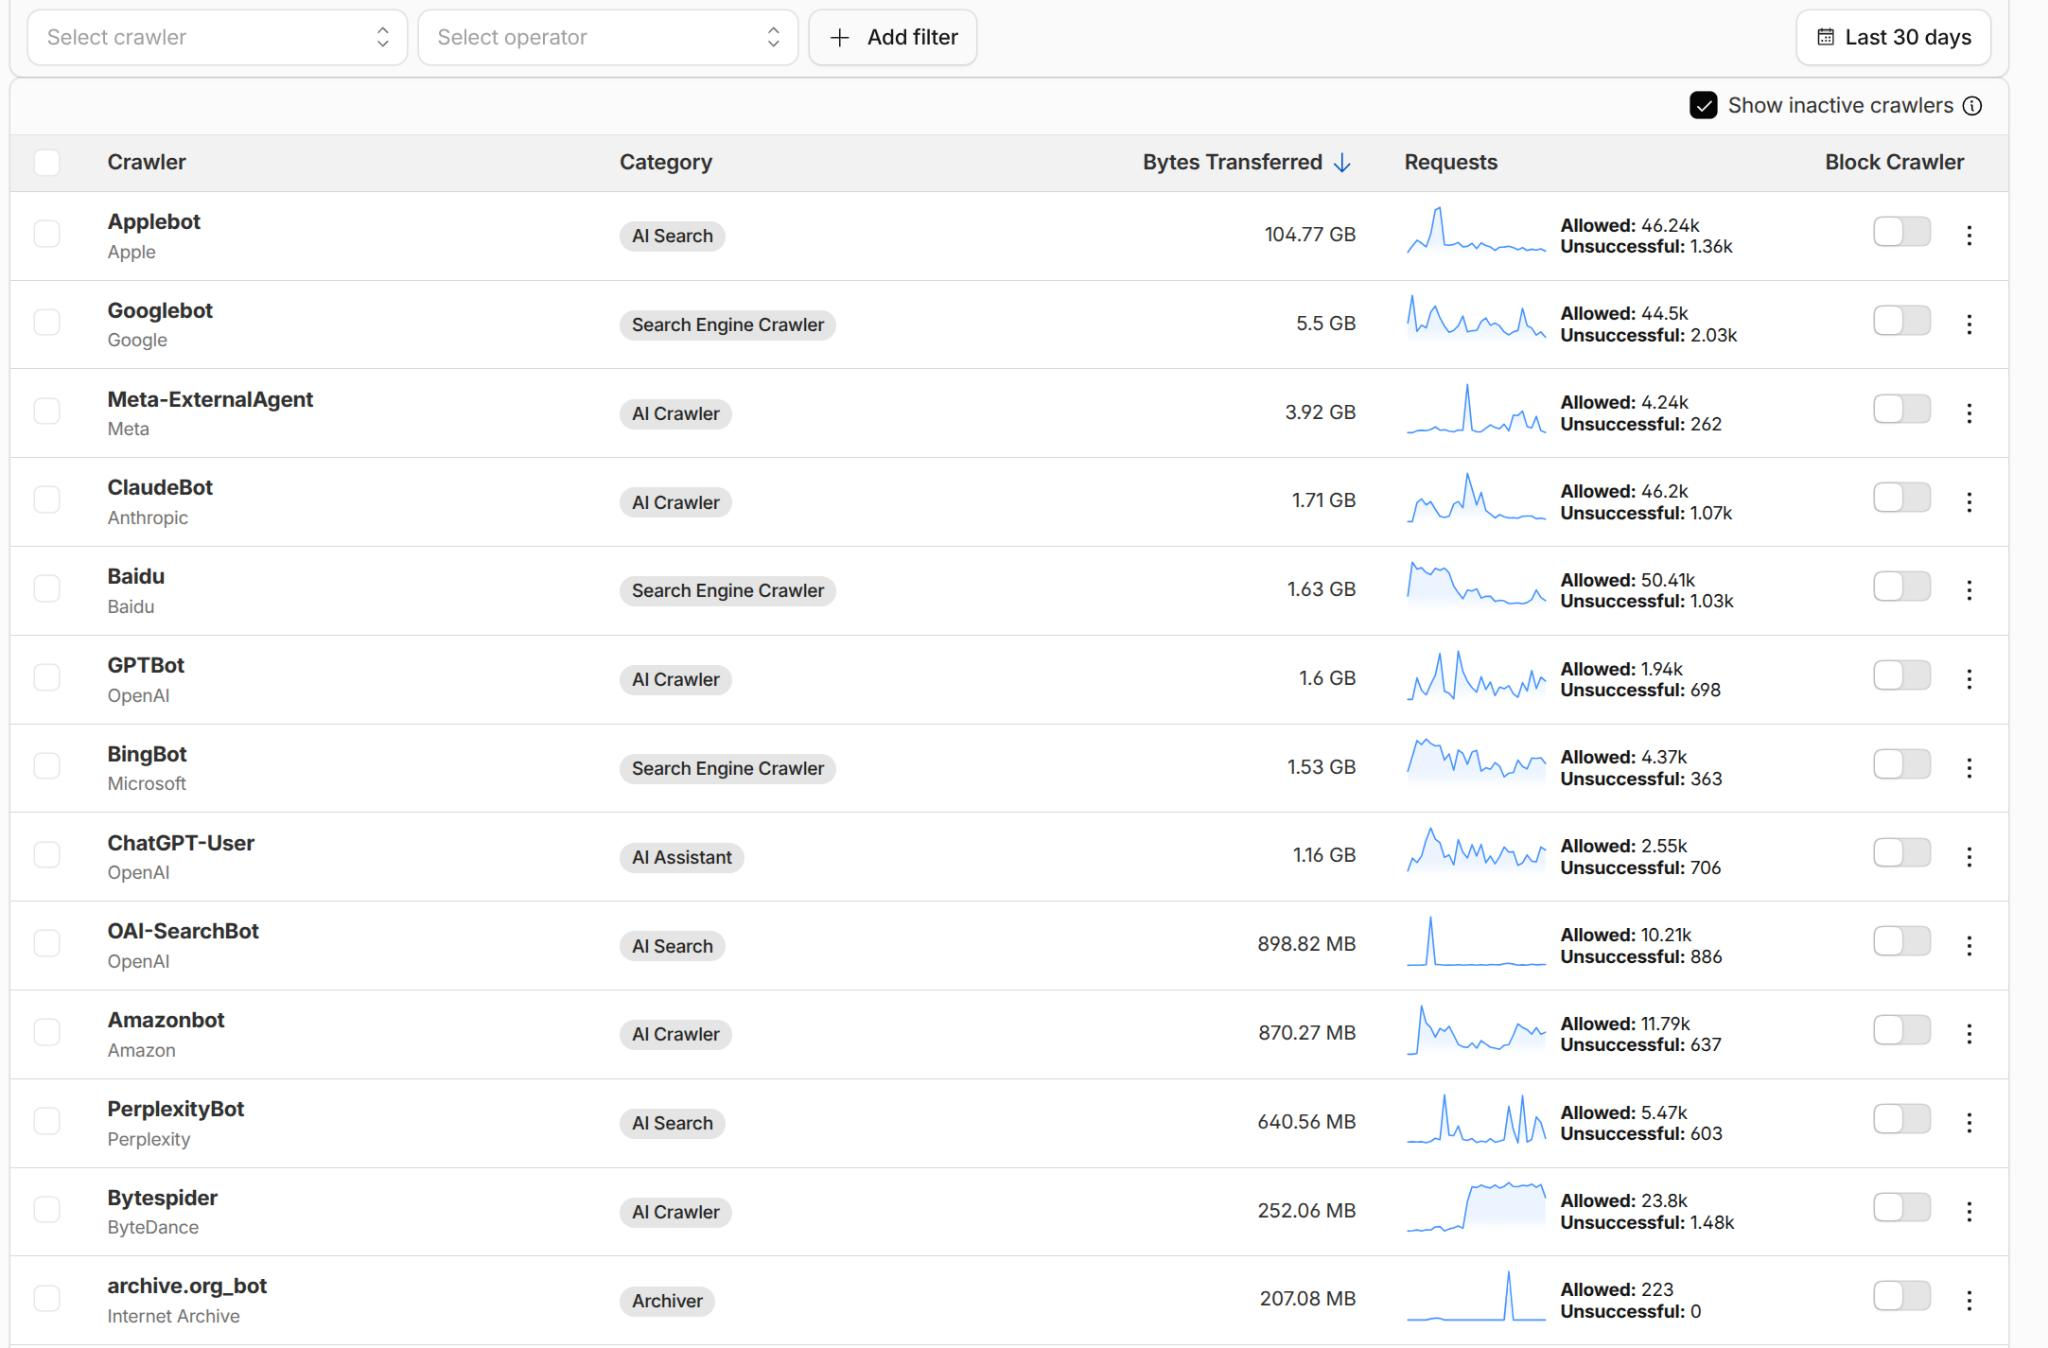
Diese - zunächst ungezügelten - Zugriffe haben dazu geführt, dass die Plattform zeitweise gar nicht mehr oder nur noch mit grossen Verzögerungen aufgerufen werden konnte.
Und es hat mehrere Monate und der Mitwirkung eines qualifizierten Freundeskreises bedurft, um sich dieser Herausforderung zu stellen; technisch, aber auch mental.
Denn es wurde notwendig zu verstehen, wie diese Systeme agieren und auf eine Webseite reagieren, auf der sich tagtäglich neue Inhalte finden - und damit potenziell auch verwerten - lassen.
Die Entscheidung, sich diesen Entwicklungen zu stellen, war unvermeidlich, wollte man auch dem Publikum eine Chance einräumen, auch weiterhin mit Gewinn auf diese Plattform zuzugreifen.
Sich diesen zu verwehren war dabei ebenso keine Alternative wie die Annahme von Empfehlungen, sich den neuen digitalen Mächten und Machenschaften zu unterwerfen.
Die nachfolgenden Überlegungen und daraus folgenden praktischen Schritte werden später nochmals an anderer Stelle ausführlicher erläutert.
Die inzwischen schon nicht mehr neuen Spieler wurden identifiziert und konnte zumindest ’in die Schranken verwiesen’ werden. Über das wie wird ebenfalls nochmals zu einem späteren Zeitpunkt berichtet.
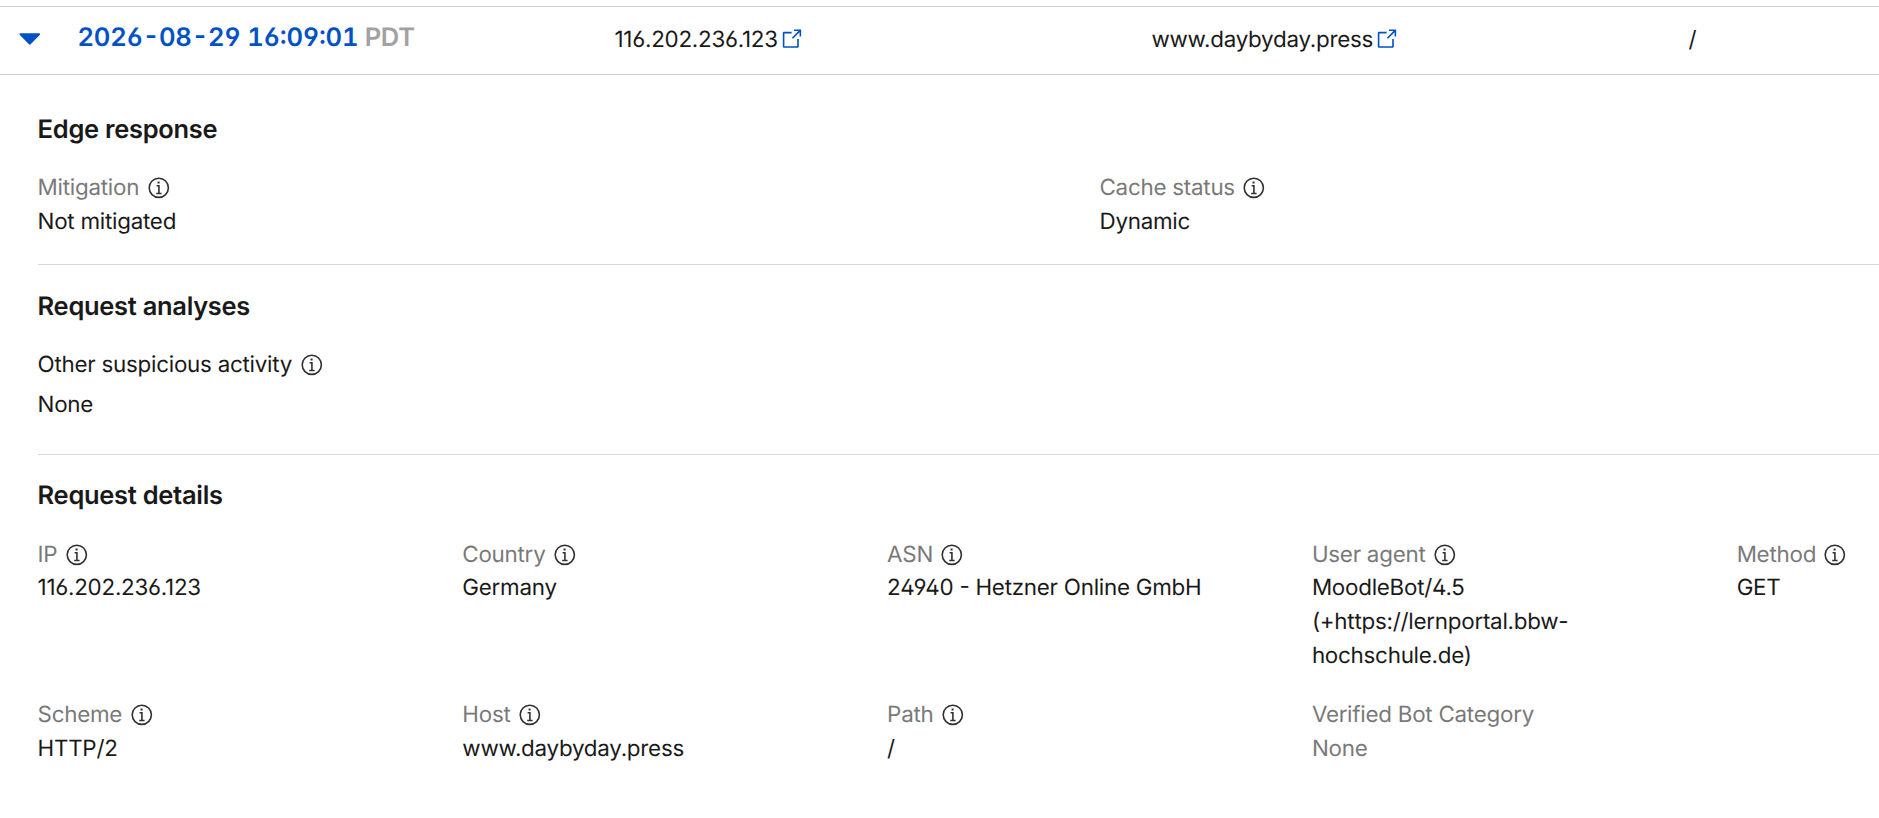
Neben den vielen Massnahmen und hier vorgelegten Daten konnte im Verlauf weiterer aufwendiger kostenpflichtiger Recherchen auch die Absender weiterer besonders aggressiver Zugriffe ausgemacht werden.
Einer dieser Angreifer wird hier als pars pro toto identifiziert und abgemahnt. Dazu vorab die Frage an Copilot: "who is: [email protected] ?"
Die Adresse [email protected] scheint keine eindeutig identifizierbare Person oder Firma zu sein. In öffentlich auffindbaren Server- und Abuse-Logs taucht sie als Kontaktadresse für einen Web-Crawler/Bot auf, konkret im User-Agent-String:
ImageBot/1.0 (compatible; research crawler; +https://github.com/rom1504/img2dataset; opt-out: [email protected])