 DaybyDay ISSN 1860-2967
Wir nutzen
– eine Ki-Software, die on premise, also auf dem eigenen Rechner lokal installiert wird:
Ollama ist eine Open-Source-Software zur lokalen Ausführung von Large Language Models (LLMs) auf Desktop-Computern.
Die Plattform ermöglicht die lokale Nutzung frei verfügbarer KI-Modelle und unterstützt die Integration mit weiteren lokalen Werkzeugen, die über eine Kommandozeilenschnittstelle oder eine Programmierschnittstelle (API) angebunden werden können. Ollama ist für macOS, Linux und Windows verfügbar.
– einen lokalen Windows 11 pro - Rechner mit viel RAM aber einer eher schwachbrüstigen NVIDIA-Grafikkarte [1]
Die neue IRIS1: der HP Z8 G4 Tower
– die Kompetenz eines begnadeten per Signal und Zoom zugeschalteten Instruktors
Weder der Rechner noch die SLM-Software sind über eine Konto-Anbindung bei dem jeweiligen Hersteller angemeldet.
Wir entscheiden uns gegen die Installation eines WSL2 (virtual Unix Environment unter Windows) - Interface und für eine direkte Installation auf dem Rechner via Windows PowerShell, inklusive JavaScript und Python library [2]:

Um auch online auf einen Blog wie diesen zugreifen zu können, wird aus der Vielzahl der Möglichkeiten ...

... HERMES aufgerufen, wiederum per Power Shell installiert ...

... und in einem ersten Testlauf aktiviert:

Schnell zeigt sich, dass wir damit die Systemumgebung überfordern, dass aber trotz aller technischen Begrenzungen die Anwendung funktioniert.
Alternativ laden wir die von Ollama angezeigte on premise - Alternative gemma4.26 mit ’nur’ 14 GB herunter
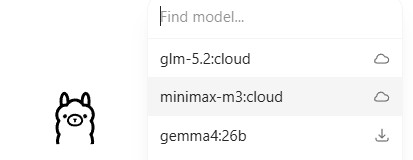
Sobald diese installiert ist, starten wir die erste ‚Selbstbefragung‘, deren hier in einem PDF zusammengefassten Ergebnis sich in einem wahrlich aufschlussreichen Binnendialog und in eine sich daran anschliessende Auskunft aufteilt:
